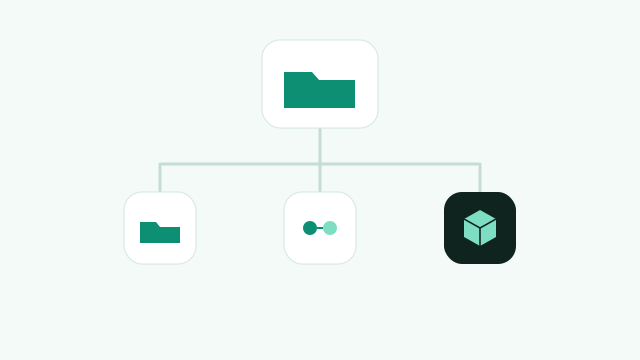
一个入口
POSIX 挂载和 HCFS 看到的是同一棵目录树。应用和大数据作业不用各维护一套路径。
统一存储访问平台
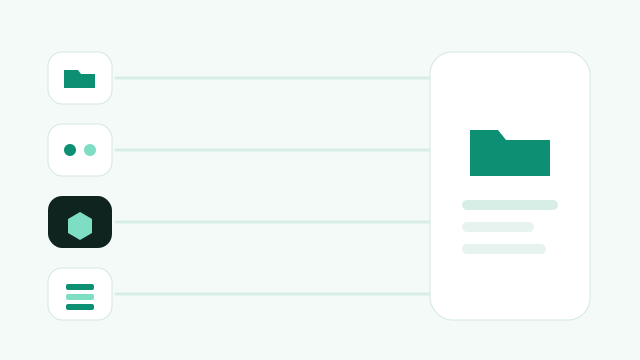
本地目录、NFS、CIFS、对象存储和 HDFS 留在原地,收进同一棵目录树。应用按 POSIX 挂载访问,Spark、Hive、Flink 通过 HCFS 接入。
需要统一访问的路径显式挂进 SynFlux。还没接进来的负载,继续直接走原来的系统。
POSIX 挂载和 HCFS 看到的是同一棵目录树。应用和大数据作业不用各维护一套路径。
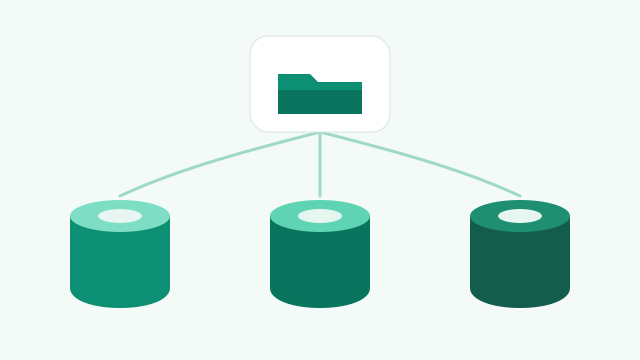
原有存储继续服务未接入的业务。上 SynFlux 不等于迁数据,也不等于停机换库。
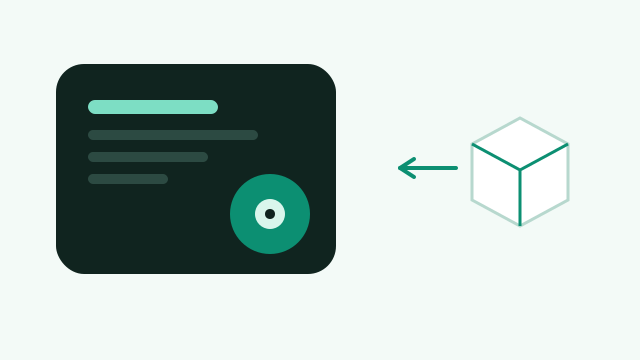
热点留在业务节点的本地磁盘,也可以放到独立的缓存集群。管理节点不转发数据。
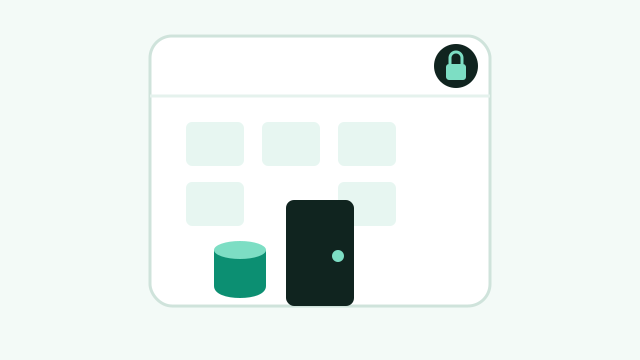
装在你自己的环境里。数据面直连你的后端,不经过我们的云。
两种入口,五类后端。对象存储和 HDFS 保持各自的语义,不在上面模拟完整 POSIX。
给应用
应用、脚本和训练作业使用一个目录。读写、建目录和常用属性走这一层。
符号链接和硬链接在本地目录与 NFSv3 上。用户扩展属性在本地目录上。文件锁限于同一挂载点,不跨节点。
给大数据
Spark、Hive、Flink 通过配置接入,业务代码不用改。
与 POSIX 挂载共享命名空间。大数据走 HCFS,SynFlux 不把自己伪装成一套 HDFS 集群。
默认在关闭、刷盘或卸载成功后写入后端。若要求写成功时后端已经有数据,可以按目录改为直达后端。
缓存可以放到单独的机器上,与计算节点分开,容量按集群扩展。
同一节点上随后就能读到。其他节点要等这次关闭完成。这不是多机同时强一致的并行文件系统。
存量
共享目录、对象桶和 HDFS 按路径进入同一棵树。应用改的是挂载点,不是底下的存储。
新建
容量放在对象存储上,目录和缓存由 SynFlux 提供。应用仍然用 POSIX 或 HCFS。
金融、运营商,以及多套存储并存的团队